模型测试接口
需要开发外部程序时,可通过 HTTP 上传模型、加速、加载并对图片推理。相机自身的采集、检测及结果输出在 CamOS 界面中配置。以下路径均接在设备的 CamOS 地址后,例如 http://<设备IP>:8000,适用于智能相机和 AI 计算盒。
DVP、DVSP 用于上传和加速;加载与推理使用 DVR、DVSR 或 JSON 流程。JSON 流程内的模型节点使用 DVR,相对模型路径从设备模型目录读取。将流程依赖的 DVR 一并上传;修改流程后释放并重新加载。
在页面中验证接口
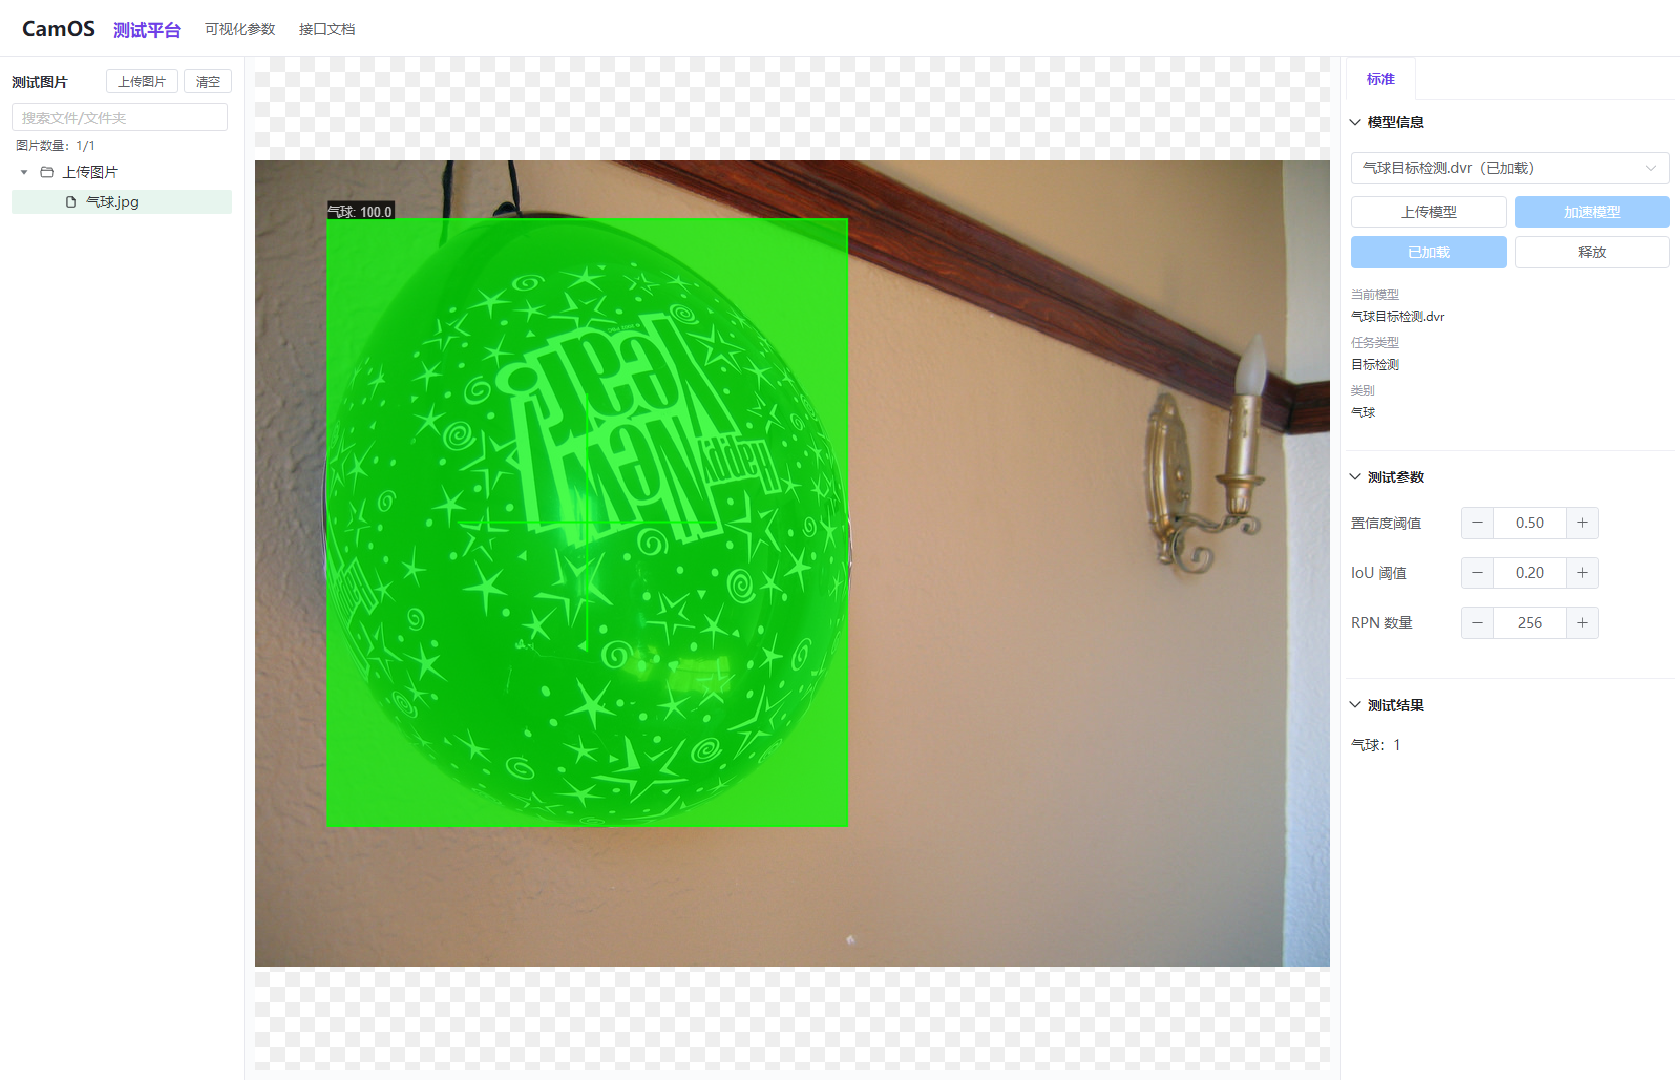
打开 http://<设备IP>:8000/test,登录后上传或选择模型、加载模型,再上传待测图片,查看可视化结果。此页面用于调试和验证图片推理接口。
下图加载气球模型,对 气球.jpg 推理,返回 1 个气球目标。
打开 http://<设备IP>:8000/model-api,查看各接口的参数和请求示例。依次完成登录、选择或上传模型、加载,再在“图片推理”中填写 model_id、选择推理图片并发送请求,右侧显示 HTTP 状态和 JSON 响应。
登录
POST /api/auth/login
以管理员账号发送 JSON:
{
  "username": "admin",
  "password": "填写设备管理员密码"
}
成功响应的 success 为 true,access_token 为认证字符串,token_type 为 Bearer,expires_in 为有效秒数。后续请求头填写 Authorization: Bearer <access_token>。
上传并选择模型
POST /api/models
请求类型为 multipart/form-data:
| 字段 | 类型 | 必填 | 含义 |
|---|---|---|---|
file | 文件 | 是 | DVP、DVR、DVSP、DVSR 或 JSON 文件 |
name | 字符串 | 否 | 文件名;省略使用上传文件名,未写后缀时补上原文件后缀 |
description | 字符串 | 否 | 模型说明 |
tags | 字符串 | 否 | 使用英文逗号分隔的标签,例如 检测,产线 |
force | 布尔值 | 否 | 默认 false;true 覆盖同名文件。覆盖前释放模型并等待加速完成 |
上传成功返回 ok: true 和模型信息 item。后续使用 item.id,其值为含后缀的完整文件名。
GET /api/models
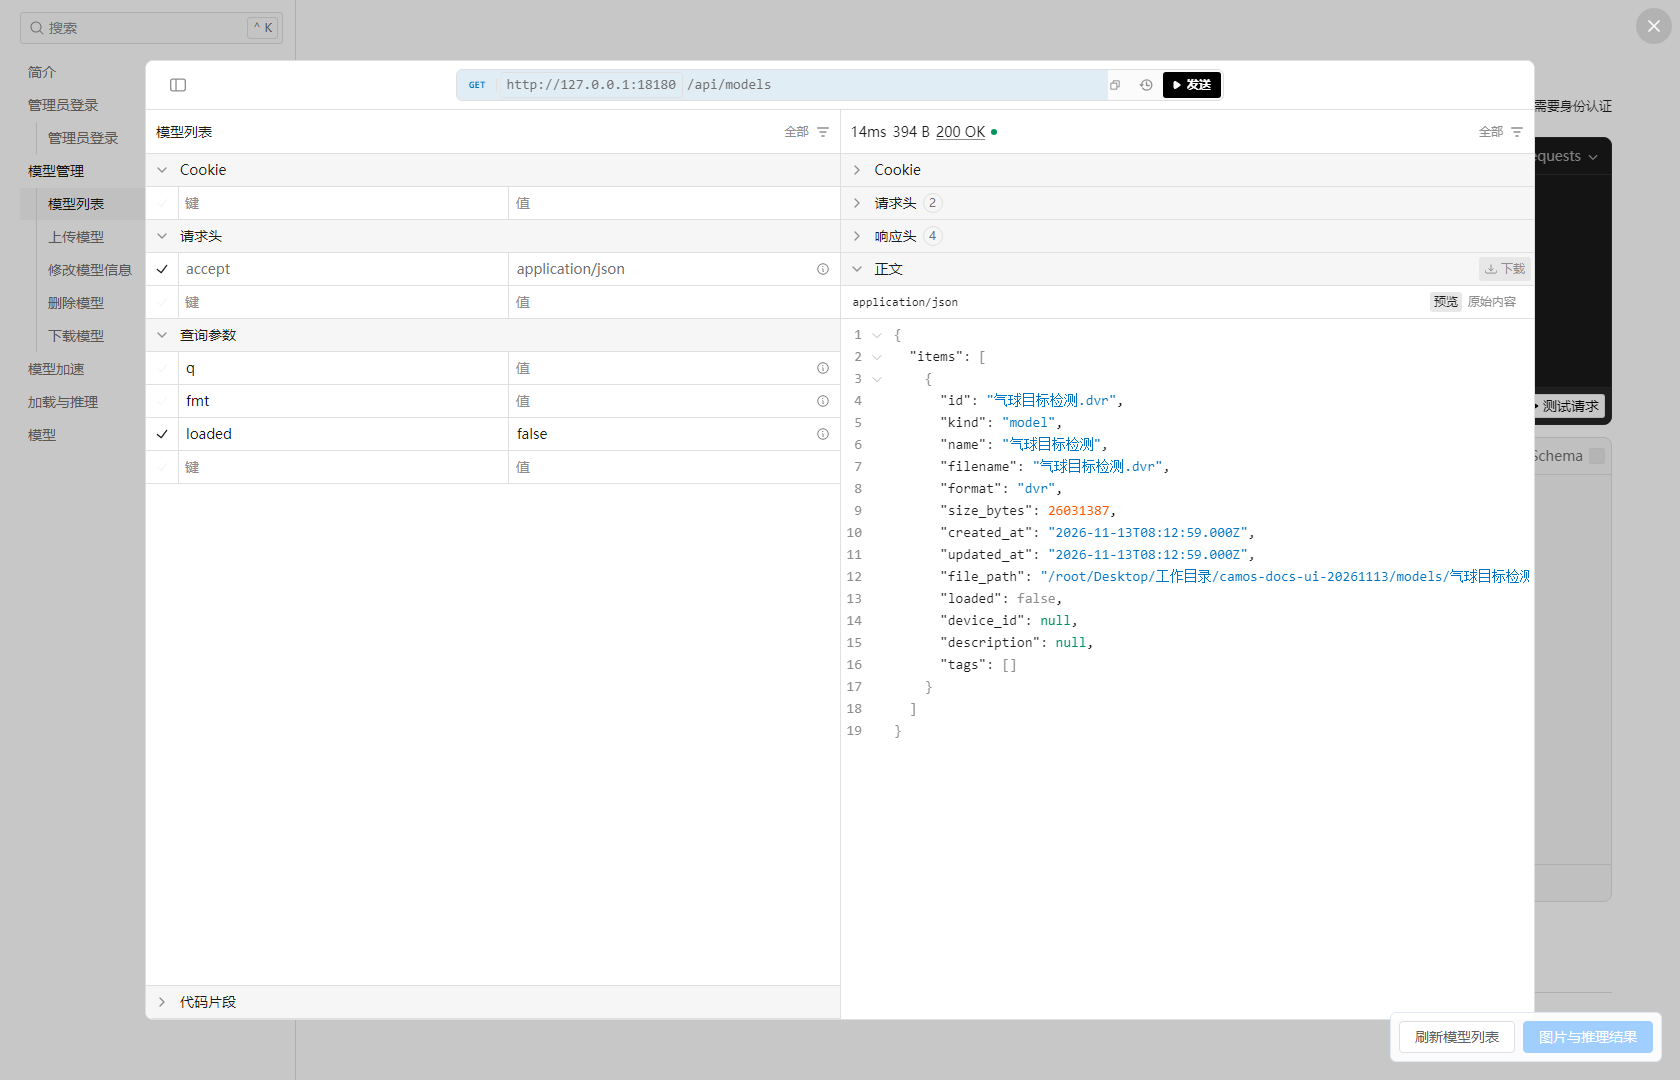
返回 items 数组。可选查询参数:q 搜索文件名、名称、说明及标签;fmt 筛选 dvp、dvr、dvsp、dvsr、json;loaded=true 筛选本接口已加载的模型,loaded=false 筛选未加载的模型。
在 /model-api 中发送模型列表请求,从 items 读取模型 id。下图列表中的模型为 气球目标检测.dvr。
| 返回字段 | 类型 | 读取方式 |
|---|---|---|
id、filename | 字符串 | 完整文件名;接口路径使用 id |
name、format | 字符串 | 显示名称与小写文件格式 |
kind | 字符串 | 资源类型,模型为 model |
size_bytes | 整数 | 文件字节数 |
created_at、updated_at | 字符串 | UTC ISO 8601 创建及更新时间 |
file_path | 字符串 | 设备上的文件位置 |
loaded | 布尔值或 null | 本模型接口的加载状态 |
device_id | 整数或 null | 加载设备编号 |
description、tags | 字符串或 null、字符串数组 | 说明和标签 |
路径中的 {model_id} 使用列表返回的原始 id,对整个文件名做一次 URL 编码。例如 Python 使用 quote(model_id, safe="")。请求体由 JSON 库编码为 UTF-8,避免手工拼接中文、引号和反斜杠。
加速 DVP 或 DVSP
POST /api/models/{model_id}/accelerate
无请求体。成功提交返回 ok: true 和 task,保存其中的 task.id。
GET /api/accelerate_tasks/{task_id}
轮询 task.status:pending 为等待,running 为执行中,success 为成功。progress 为 0~100 的进度;output_name 为生成的 DVR 或 DVSR 文件名,用于下一步加载。设备同时执行一个加速任务。
GET /api/accelerate_tasks
返回 ok: true 与 items,列出当前服务最近最多 50 个加速任务。
加载模型或流程
POST /api/models/{model_id}/load
请求体可省略,或发送 {},默认 device_id 为 0;显式指定设备时发送:
{
  "device_id": 0
}
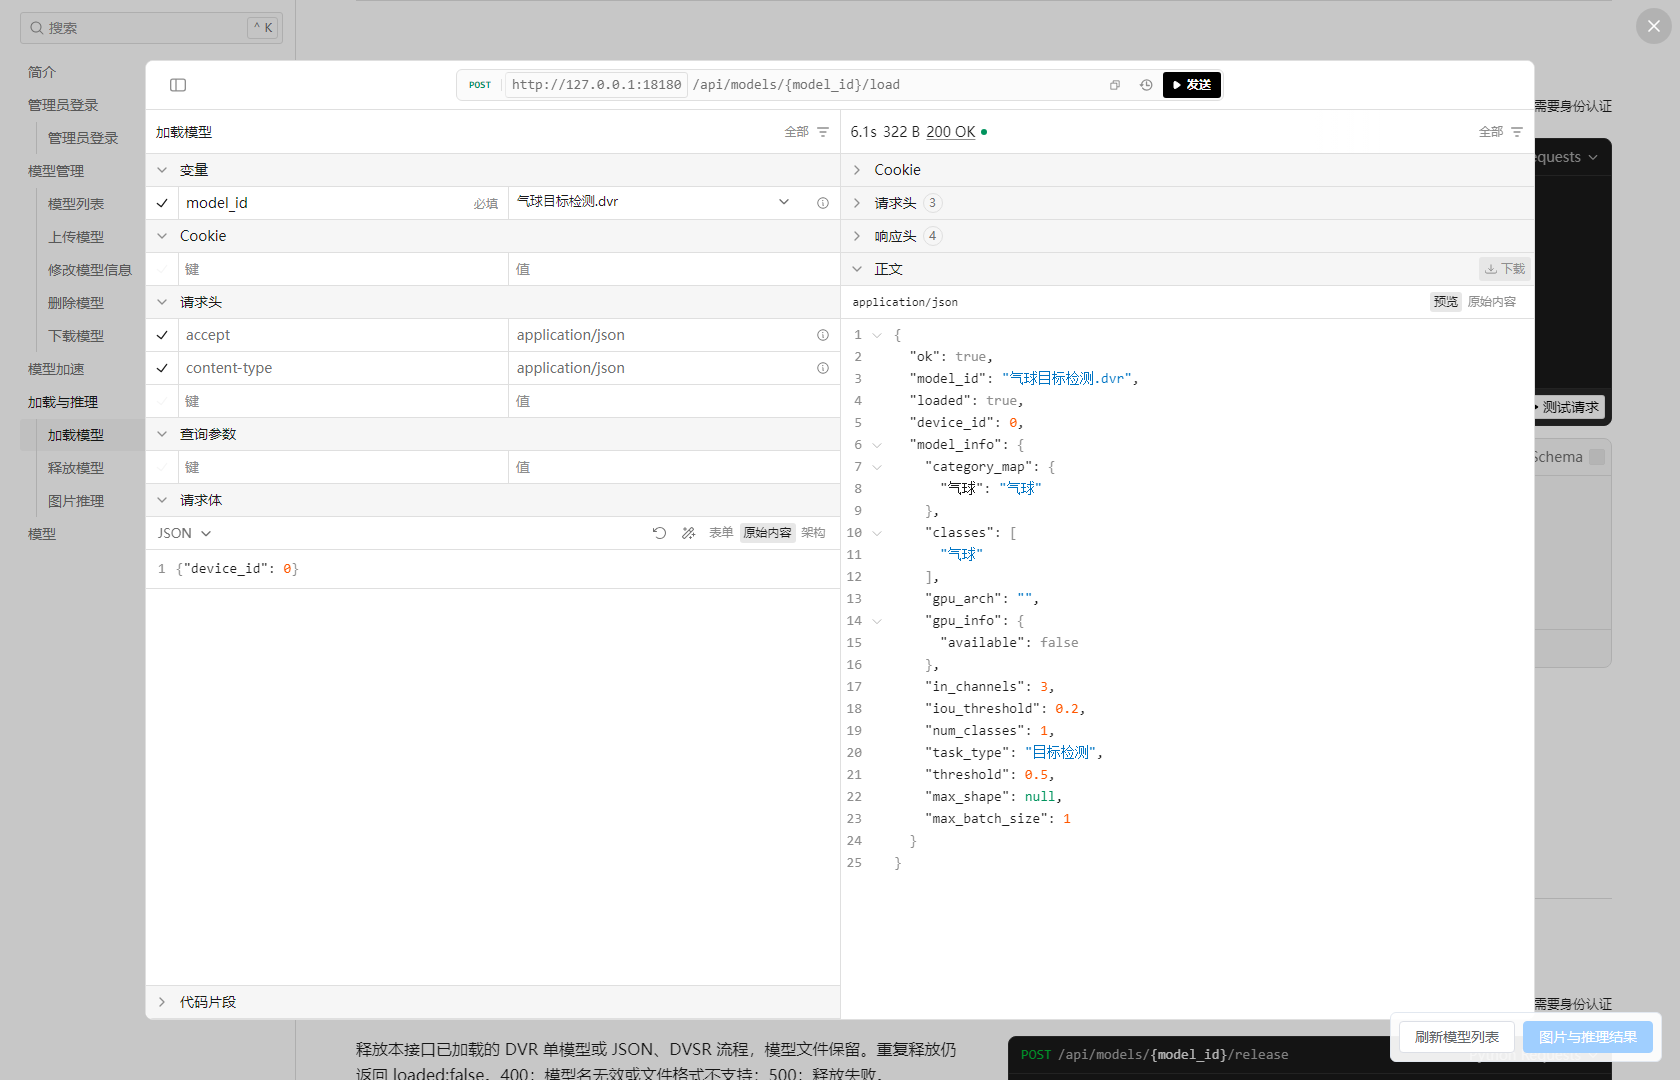
成功返回 ok: true、loaded: true、model_id、device_id 和 model_info。model_info 包含任务类型、类别、输入尺寸等随模型变化的元信息。更换设备前先释放模型。
图片推理
POST /api/models/{model_id}/infer
将图片文件字节转为 base64,放入 JSON 的 img 字符串。单张文件最大 20 MiB,像素数最大 16777216。以下完整 JSON 包含一张 1×1 白色 PNG,仅演示编码与请求结构:
{
  "img": "iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAIAAACQd1PeAAAADElEQVR4nGP4//8/AAX+Av4N70a4AAAAAElFTkSuQmCC"
}
对实际待测图片,可运行下列代码生成完整 JSON 请求体文件,按后文完整 Python 示例发送。/model-api 中也可点击“选择推理图片”,由页面自动编码并填入请求体:
import base64
import json
from pathlib import Path

image_path = Path(input("待测图片路径:"))
request_body = {"img": base64.b64encode(image_path.read_bytes()).decode("ascii")}
Path("infer-request.json").write_text(
    json.dumps(request_body, ensure_ascii=False), encoding="utf-8"
)
请求体中的 with_mask 为可选布尔值,默认 true。DVR 的掩膜显示由查询参数 display_mask、display_contours 控制,返回的轮廓和掩膜数据由 return_polygon、return_mask_rle 控制。JSON、DVSR 流程按照各节点参数运行。
DVR 单模型的常用查询参数如下,Python 请求中通过 params 传入:
| 参数 | 类型 | 默认或省略时行为 | 含义 |
|---|---|---|---|
threshold | 浮点数 | 分类为 0;其他任务取模型阈值,缺少时 0.5 | 置信度阈值 |
iou_threshold | 浮点数 | 0.2 | 检测框 IoU 阈值 |
top_k | 整数 | 分类为 1;检测为 0 | 分类返回前 K 类;检测正数限制结果数,0 不限制 |
return_vis | 布尔值 | false | 请求可视化图像 |
return_polygon | 布尔值 | false | 返回分割轮廓 |
return_mask_rle | 布尔值 | false | 返回数字 RLE 掩膜 |
display_mask | 布尔值 | true | 在可视化图像中显示掩膜 |
display_contours | 布尔值 | true | 在可视化图像中显示轮廓 |
在 /model-api 中使用同一气球模型和图片发送推理请求,返回 code: "00000"、类别“气球”、置信度约 0.99995 及目标框 bbox。
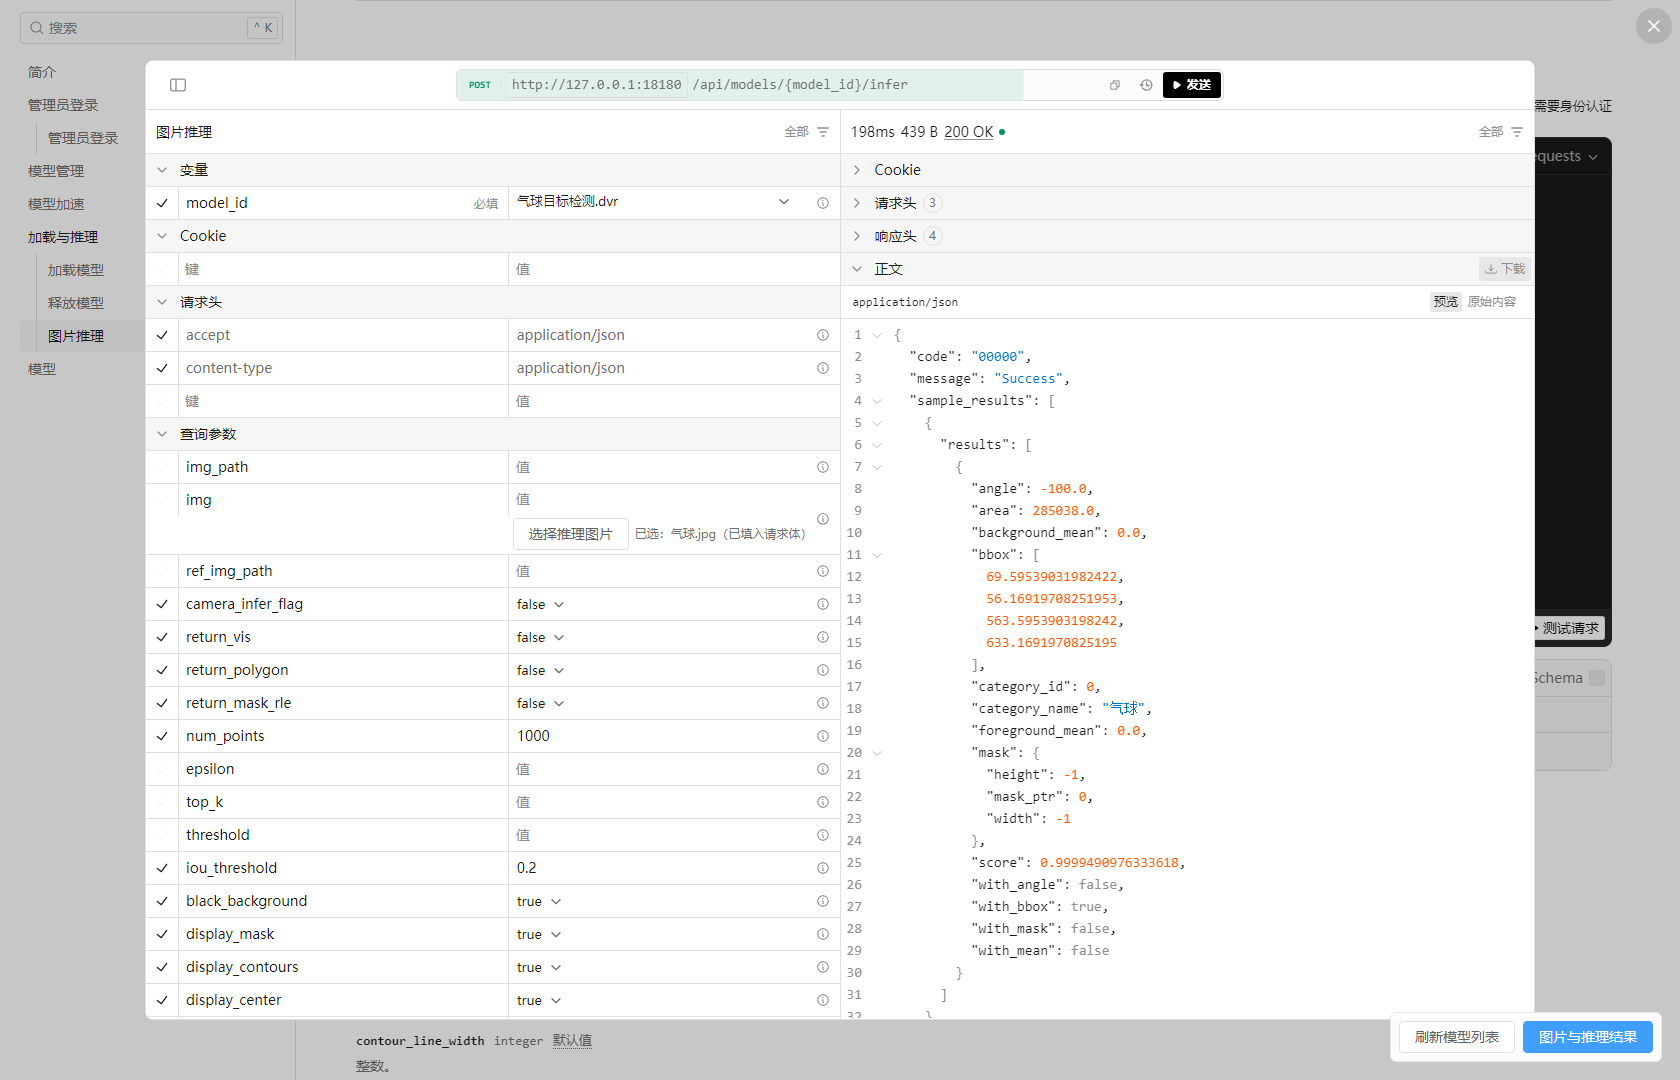
成功响应的 code 为字符串 "00000",每张图的目标从 sample_results[i].results 读取。以下展示检测结果的主要字段,数值用于说明读取方式:
{
  "code": "00000",
  "task_type": "检测",
  "sample_results": [
    {
      "results": [
        {
          "category_id": 0,
          "category_name": "气球",
          "score": 0.98,
          "bbox": [120.0, 80.0, 300.0, 260.0]
        }
      ]
    }
  ]
}
task_type 为任务类型;category_id 为整数类别编号,category_name 为类别名,score 为浮点置信度,普通检测框的 bbox 为原图像素坐标 [x1, y1, x2, y2]。旋转框以 [cx, cy, w, h, angle] 返回中心点、宽高和角度;坐标、宽高单位为像素,角度单位为弧度。流程返回末端节点输出,结果坐标对应原图。查询参数 return_vis=true 请求可视化;visualization 按任务返回 PNG 或 JPEG 的 base64 字符串。该字段有值时解码,根据图片字节保存为对应格式。
分割任务可在 sample_results[i].results[j] 中返回 with_mask、area、polygon 或 mask_rle。area 为分割面积,polygon 为原图像素轮廓点数组;mask_rle 包含整数 width、height 和整数数组 runs,按行展开,首段记录背景长度。带普通检测框时,左上角取 floor(x1)、floor(y1),右下角取 ceil(x2)、ceil(y2),掩膜按该整数区域的宽高输出,将其放回对应位置。轮廓和掩膜字段根据任务及上述返回参数提供。
完整 Python 调用
在电脑安装 requests 后运行。地址、模型文件名和图片路径在运行时输入,密码通过隐藏输入读取。模型预先上传并加速为 DVR,或选择已上传的 JSON、DVSR。
import base64
import getpass
import json
from pathlib import Path
from urllib.parse import quote

import requests

base_url = input("CamOS 地址:http://设备IP:8000\n").rstrip("/")
username = input("管理员账号:")
password = getpass.getpass("管理员密码:")
model_id = input("模型完整文件名(含后缀):")
image_path = Path(input("图片路径:"))

session = requests.Session()
login = session.post(
    f"{base_url}/api/auth/login",
    json={"username": username, "password": password},
    timeout=15,
)
login.raise_for_status()
session.headers["Authorization"] = f"Bearer {login.json()['access_token']}"
model_url = f"{base_url}/api/models/{quote(model_id, safe='')}"

loaded = session.post(f"{model_url}/load", json={}, timeout=300)
loaded.raise_for_status()
assert loaded.json()["loaded"] is True
try:
    image_base64 = base64.b64encode(image_path.read_bytes()).decode("ascii")
    response = session.post(
        f"{model_url}/infer",
        params={"return_vis": True},
        json={"img": image_base64},
        timeout=300,
    )
    response.raise_for_status()
    result = response.json()
    assert result["code"] == "00000", result
    print(json.dumps(result["sample_results"], ensure_ascii=False, indent=2))
    visualization = result.get("visualization")
    if visualization:
        image_bytes = base64.b64decode(visualization)
        suffix = ".png" if image_bytes.startswith(b"\x89PNG\r\n\x1a\n") else ".jpg"
        Path(f"result{suffix}").write_bytes(image_bytes)
finally:
    released = session.post(f"{model_url}/release", timeout=60)
    released.raise_for_status()
    assert released.json()["loaded"] is False
释放与管理文件
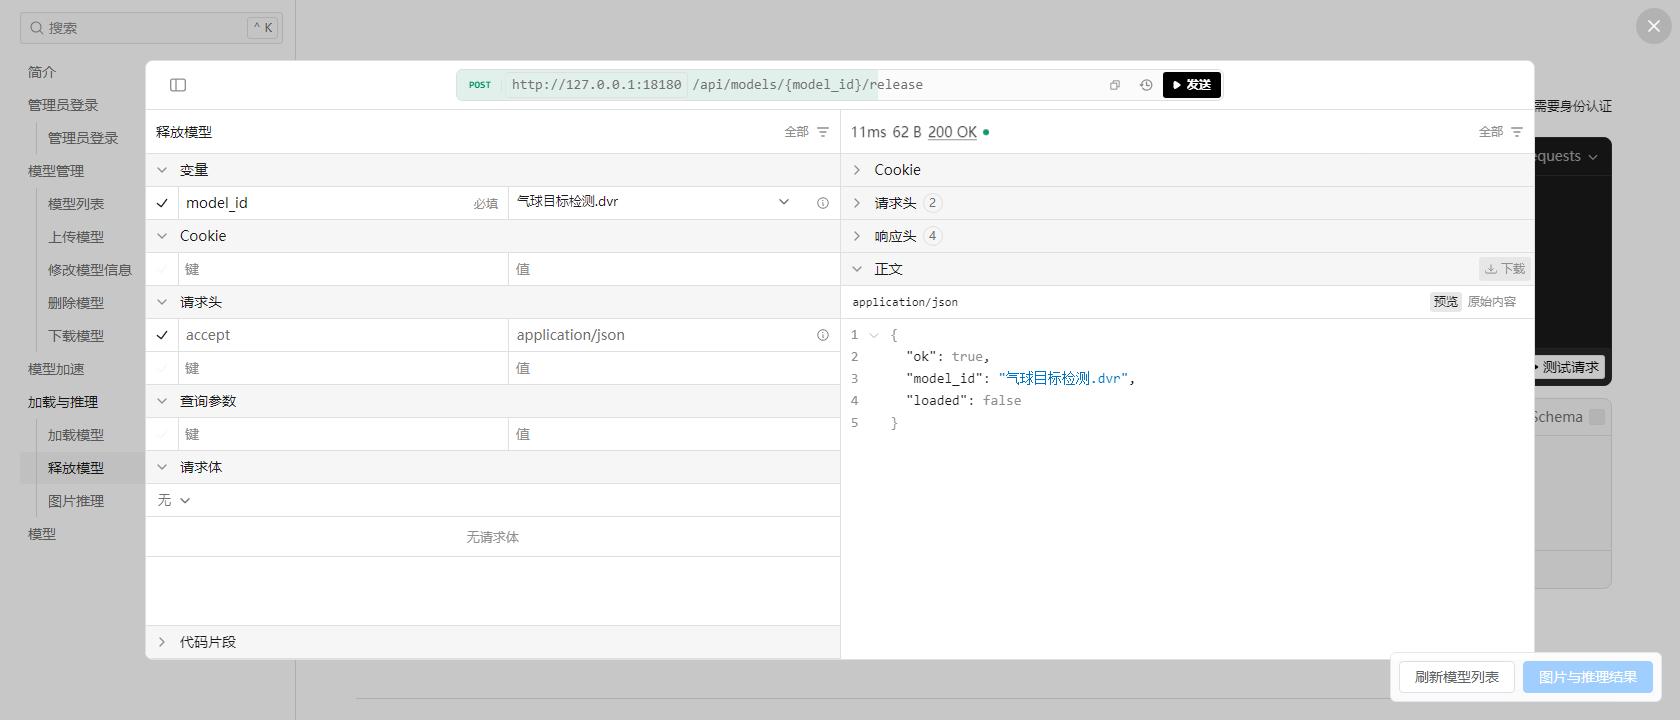
POST /api/models/{model_id}/release
无请求体。成功返回 ok: true、model_id 和 loaded: false,模型文件保留。
| 操作 | 方法与路径 | 用法 |
|---|---|---|
| 下载文件 | GET /api/models/{model_id}/download | 响应为模型文件字节 |
| 修改信息 | PATCH /api/models/{model_id} | 用于 DVP、DVR、DVSP、DVSR;JSON 请求体可选字段 name、description、tags,使用返回的 item.id 继续调用 |
| 删除文件 | DELETE /api/models/{model_id} | 用于 DVP、DVR、DVSP、DVSR;先释放模型并等待加速结束,成功返回 ok: true |
修改信息时,name 为不含扩展名的新名称,description 为字符串或 null,tags 为字符串数组。省略字段保留原值;说明填空字符串或 null 可清空,标签填 [] 可清空。JSON 流程的编辑和删除使用流程编辑器。
响应字段与成功条件
确认 HTTP 请求成功并解析 JSON 后,按对应接口读取业务结果:
| 接口 | 成功条件 | 主要响应字段 |
|---|---|---|
POST /api/auth/login | success 为 true | access_token 用于后续认证;expires_in 为有效秒数 |
GET /api/models | 返回 items 数组 | 模型列表;空数组表示当前无匹配模型 |
POST /api/models | ok 为 true | item.id 为上传后的完整模型文件名 |
POST /api/models/{model_id}/accelerate | ok 为 true,加速任务已创建 | task.id 用于查询进度 |
GET /api/accelerate_tasks/{task_id} | ok 为 true 表示查询成功;task.status 为 success 表示加速完成 | task.output_name 为生成的模型文件名 |
GET /api/accelerate_tasks | ok 为 true | items 为加速任务数组 |
POST /api/models/{model_id}/load | ok、loaded 均为 true | model_id、device_id、model_info 为已加载模型及设备信息 |
POST /api/models/{model_id}/infer | code 为字符串 "00000" | sample_results 为图片结果数组;visualization 按任务提供 |
POST /api/models/{model_id}/release | ok 为 true、loaded 为 false | model_id 为已释放模型 |
读取响应中的 detail、error 或 message;加速任务状态为 failed 时读取 task.error。